AI-native SDLC는 AI 에이전트를 전제로 소프트웨어 개발 수명 주기(SDLC, Software Development Life Cycle)를 설계하는 접근입니다. 기능을 요청한 이유부터 배포 후 발견한 문제까지 개발 과정에 포함합니다.
Anthropic의 AI-native SDLC 플레이북 ↗은 구현 속도가 빨라질수록 요구사항 정리와 검토 대기가 병목으로 남는다고 설명합니다. Louis Claxton이 작성했으며, 페이지에 표시된 날짜는 2026년 8월 21일입니다.
이 글은 원문의 구조를 짧게 소개한 뒤, 프론트엔드의 목록 필터 기능에 적용해 봅니다. 아래 적용 예제와 도입 제안은 필자가 구성했습니다.
원문이 제안하는 6단계
플레이북은 개발 과정을 여섯 단계로 나눕니다. 각 단계의 결과가 다음 작업의 입력이 됩니다. 아래 표의 Plan은 문제와 목표를 정하는 단계입니다. 구체적인 구현 계획인 plan.md는 Build 단계에서 작성합니다.
| 단계 | 다음 단계에 넘기는 내용 |
|---|---|
| Plan | 해결할 문제와 제약을 담은 intent.md |
| Design | 요구사항과 설계를 담은 spec.md |
| Build | 승인된 plan.md, 구현과 변경 기록 |
| Test | 테스트·빌드·화면 확인의 근거 |
| Deploy | 검토 결과와 환경별 승인 기록 |
| Maintain | 운영 문제를 담은 intent.md |
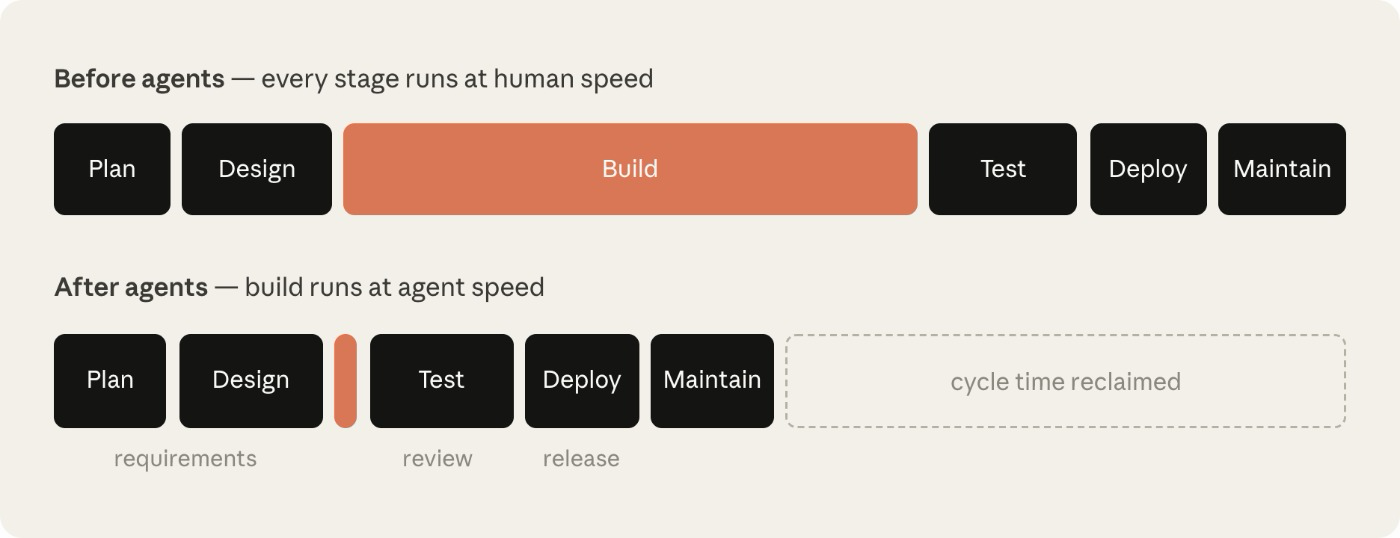
원문의 개념도입니다. 막대 길이는 실측 성능 수치가 아닙니다. 구현 외 단계에도 시간이 필요하다는 관계를 나타냅니다. 출처: Anthropic 플레이북 ↗.
원문은 CLAUDE.md로 공통 지식을 전달하고, 스킬로 절차를 안내하며, 후크로 작업을 통제하는 역할을 구분합니다. 테스트와 에이전트 구성 평가를 연결하고, 배포에는 승인 경계를 둡니다. 운영에서 감지한 문제는 다시 개발 입력으로 돌려보냅니다. 상세한 구성은 원문 ↗에서 확인할 수 있습니다.
적용 예제: 목록으로 돌아왔을 때 필터를 유지하기
“필터 상태를 유지해 줘”라는 요청으로 작업을 시작한다고 가정해 보겠습니다. 구현자는 상태를 저장할 위치부터 고민할 수 있습니다. 하지만 요청만으로는 새로고침이나 공유 링크의 동작을 결정할 수 없습니다.
먼저 제품 동작을 정해야 합니다. 이 예제에서는 카테고리와 정렬 조건을 URL에 저장하고, 상세 화면에서 돌아와도 같은 조건으로 목록을 보도록 정하겠습니다. 검색어와 페이지 번호는 범위에서 제외합니다.
intent.md에는 사용자의 문제를 적습니다
다음은 설명용 intent.md입니다.
# 목록 탐색 조건 유지

## 문제

사용자가 카테고리를 고른 뒤 상세 화면을 보고 돌아오면
필터가 초기화되어 같은 조건을 다시 선택해야 한다.

## 목표

상세 화면에서 뒤로 가면 직전에 선택한 카테고리와 정렬을 유지한다.
같은 URL로 진입하면 같은 필터 조건을 적용한다.

## 범위

- 카테고리와 정렬 조건만 다룬다.
- 검색어, 페이지 번호, 스크롤 위치 복원은 포함하지 않는다.
- 서버의 목록 API 계약은 변경하지 않는다.

## 결정할 질문

- 잘못된 카테고리가 URL에 있으면 어떻게 처리할까?
- 조건 변경 때마다 브라우저 방문 기록을 남길까?
이 단계에서는 저장 라이브러리를 선택하지 않았습니다. “같은 필터 조건”과 “같은 검색 결과”도 구분해야 합니다. 데이터가 갱신되면 결과 목록은 달라질 수 있으므로, 이 기능이 보장할 범위를 조건 유지로 한정합니다.
spec.md에는 관찰할 수 있는 동작을 적습니다
앞의 질문에 답했다면 이를 수용 기준으로 바꿉니다. 수용 기준은 구현을 받아들일 수 있는지 판단하는 조건입니다.
| 상황 | 이 예제의 기대 동작 |
|---|---|
category=books&sort=recent로 직접 진입 | 도서 카테고리와 최신순을 선택하고 같은 조건으로 조회 |
| 필터를 바꾼 뒤 상세 화면에서 뒤로 가기 | 직전 목록 URL의 조건을 복원 |
| 목록에서 새로고침 | URL의 조건으로 다시 조회 |
| 지원하지 않는 카테고리로 진입 | 카테고리를 전체로 바꾸고 유효한 정렬 조건은 유지 |
| 필터를 연속해서 변경 | 현재 목록의 방문 기록을 교체하여 필터별 기록 누적 방지 |
마지막 행은 제품 선택입니다. 필터 변경 하나하나를 뒤로 가기로 되돌려야 하는 서비스라면 다른 기준을 정해야 합니다. AI가 편한 구현을 택하면서 탐색 동작까지 결정하게 두지 않습니다.
이 예제에서는 URL을 필터 조건의 기준으로 삼습니다. 화면의 선택 상태와 API 요청은 그 조건에서 파생합니다. 세 값을 따로 갱신하면 주소는 도서인데 화면은 전체 카테고리인 상태가 생길 수 있습니다.
plan.md에는 변경 순서와 확인 방법을 적습니다
설명용 구현 계획은 다음처럼 구성할 수 있습니다.
# 목록 필터 구현 계획

1. URL에서 카테고리와 정렬 조건을 읽는 파서를 작성한다.
   - 각 조건의 허용하지 않는 값과 누락된 값을 해당 조건의 기본값으로 변환한다.
   - 기존 목록 API가 받는 값으로 변환한다.
2. 필터 UI와 목록 요청이 같은 파싱 결과를 사용하게 한다.
3. 필터를 변경하면 현재 목록 URL을 교체한다.
4. 상세 화면으로 이동했다가 돌아오는 흐름을 확인한다.

## 검증

- 파서: 정상값, 누락값, 잘못된 값의 처리
- 화면: URL 직접 진입, 새로고침, 상세 화면에서 뒤로 가기
- 회귀: 기본 목록 조회와 상세 화면 이동

## 재검토 조건

목록 API 계약이나 공통 라우팅 구조를 바꿔야 하면
구현을 확대하기 전에 요구사항과 계획을 다시 검토한다.spec.md는 결과를 판단하는 기준이고, plan.md는 그 결과에 도달하는 작업 순서입니다. 계획을 읽는 개발자는 API 변경이 필요한지 판단할 수 있어야 합니다. 계획만 보고 기대 동작을 알 수 없다면 요구사항을 다시 연결합니다.
검토자가 기능을 다시 추론하지 않게 만들기
PR 설명에는 변경 파일 목록보다 동작별 근거가 필요합니다. 앞의 예제라면 URL 파서 테스트만으로는 뒤로 가기 동작을 확인할 수 없습니다. 상태 변환과 브라우저 탐색을 따로 검증해야 합니다.
검토 자료를 다음처럼 구성할 수 있습니다.
- 요청과 연결: 필터 복원 문제를 설명한 티켓과 수용 기준을 연결합니다.
- 자동 검사: URL 값의 해석과 기본값 처리 결과를 붙입니다.
- 화면 확인: 상세 진입 후 복귀, 새로고침, 직접 진입의 확인 결과를 남깁니다.
- 남은 판단: 방문 기록 교체 방식과 잘못된 URL 처리 방식의 승인을 요청합니다.
이렇게 나누면 리뷰어는 “왜 URL을 바꾸었는가”를 diff에서 추측할 필요가 없습니다. 테스트가 통과했어도 방문 기록 정책이 제품 의도와 다르면 요구사항을 다시 논의할 수 있습니다.
기존 글 SDD와 TDD를 결합하는 방법은 명세와 테스트의 관계를 다룹니다. 이번 예제에서는 그 관계에 브라우저 동작과 제품 판단을 함께 붙였습니다.
작은 팀이라면 문서보다 결정의 누락을 먼저 줄입니다
세 파일을 모든 수정에 의무화하면 오탈자 수정에도 같은 비용이 듭니다. 필자는 작업 규모에 따라 기록 위치를 조정하도록 제안합니다.
한 화면의 변경이라면 기존 티켓에 문제와 수용 기준을 적고, PR에 구현 계획과 검증 근거를 남길 수 있습니다. 여러 사람이 순차적으로 맡거나 여러 서비스에 걸친 작업이라면 별도 문서가 도움이 됩니다. 다음 담당자가 대화 기록을 읽지 않아도 결정의 이유를 찾을 수 있는지가 기준입니다.
예제의 운영 과정에서 “예전에 저장한 카테고리 링크가 전체 목록으로 바뀐다”는 제보가 들어왔다고 가정해 보겠습니다. 이를 바로 파서 버그로 단정하면 안 됩니다. 카테고리 폐지 정책과 잘못된 값 처리 기준부터 확인합니다.
폐지된 카테고리를 안내해야 한다면 새로운 요구사항입니다. 기존 수용 기준을 수정하고, 폐지된 값으로 진입하는 사례를 검증에 추가합니다. 반대로 현재 정책에 맞는 동작이라면 종결 이유를 남깁니다. 모든 제보가 코드 수정으로 이어질 필요는 없습니다.
도입 효과도 이 기능을 기준으로 확인할 수 있습니다. 요구사항 확정까지 걸린 시간, 검토 대기 시간, 병합 후 같은 동작을 고친 횟수를 기록해 보세요. 생성한 코드의 양보다 팀이 어디에서 멈추는지 판단하기 쉽습니다. 속도와 함께 재작업이 늘었다면 다음 작업에서는 수용 기준부터 보강합니다.
참고 자료
- Anthropic — AI-native SDLC 플레이북 ↗: 2026년 8월 21일로 표시된 원문. 2026년 10월 17일 열람.
- 푸땡로그 — SDD와 TDD의 결합으로 AI 코딩 에이전트 활용하기