Gemini 4 Argon은 코딩, 문서 분석, 사이버 방어처럼 여러 단계를 거치는 작업을 겨냥한 Google의 AI 모델입니다. GPT-6 Astra와 Claude Fable 5.1도 장기 에이전트 작업을 지원하지만, 앞서는 평가와 제품의 사용 조건은 서로 다릅니다.
모델을 고를 때는 업무에 가까운 성능과 실제로 사용할 도구·권한을 함께 비교해야 합니다. 이 글에서는 세 모델의 공개 점수를 차트로 살펴보고, API·개발 환경·안전장치가 선택에 주는 영향을 짚습니다.
기준: 2026-10-14. 성능 수치는 Google DeepMind의 Argon 모델 카드 ↗에 실린 2026년 10월 평가표를 사용합니다. Google이 공개한 비교이며, 독립 평가의 종합 순위는 아닙니다.
Argon은 입력과 출력을 합쳐 최대 100만 토큰을 지원합니다
Argon은 텍스트·이미지·오디오·비디오를 입력으로 받고 텍스트를 출력합니다. 모델 카드 ↗가 명시한 컨텍스트 한도는 입력과 출력을 합쳐 최대 100만 토큰입니다. 긴 코드베이스, 여러 문서, 녹화 영상의 정보를 한 작업에서 다룰 수 있습니다.
컨텍스트는 모델이 한 번의 작업에서 다룰 수 있는 정보의 범위입니다. 토큰은 그 분량을 세는 단위입니다. 입력으로 한도를 많이 쓰면 출력에 남는 여유도 줄어듭니다. 긴 컨텍스트가 자료의 최신성이나 답변의 사실성을 보장하지는 않습니다. 모델 카드도 환각과 간헐적인 응답 지연·시간 초과를 한계로 명시합니다.
Argon은 입력에 따라 일부 전문가 경로를 선택하는 sparse mixture-of-experts(MoE) Transformer 구조를 사용합니다. 이 구조만으로 실제 비용이나 응답 속도를 판단할 수는 없습니다. 도입할 때는 문서 묶음의 크기와 출력 분량을 정하고, 실제 API 사용량을 측정해야 합니다.
9월 30일 최초 발표 ↗ 때는 Fairwind Program의 신뢰된 사이버 방어자에게 먼저 제공했습니다. 10월 13일 개발자 안내 ↗부터는 유료 Gemini API, AI Studio, Android Studio로 접근 범위가 넓어졌습니다. Google AI Ultra 구독자는 AI Studio와 Google Antigravity에서도 사용할 수 있습니다.
성능은 같은 평가 안에서 비교합니다
아래 차트는 세 모델을 여섯 평가에서 비교합니다. 모든 막대의 범위는 0~100%이며, 높을수록 좋은 점수입니다. Fable 5.1의 공개값이 없는 항목은 0점으로 표시하지 않았습니다.
평가마다 과제와 채점 방식이 다르므로 서로 다른 차트의 점수를 평균 내거나 종합 순위로 읽지 않습니다. 특히 GraphWalks는 그래프 탐색 과제의 F1 점수이며, 일반 문서 검색의 정확도를 뜻하지 않습니다.
지식 업무 · Vals Index
금융·코딩·법률·세무 업무를 묶은 지표입니다.
코드 변경 · DeepSWE v1.1
실제 코드베이스에서 장기 소프트웨어 엔지니어링 과제를 평가합니다.
코드 변경 · FrontierSWE v2
DeepSWE와 별개의 평가입니다. 하네스와 성공 조건을 함께 확인합니다.
긴 문맥 · GraphWalks
256K~1M 토큰 구간의 너비 우선 탐색(BFS) F1 점수입니다.
컴퓨터 사용 · Agent's Last Exam
통과율입니다. 브라우저·컴퓨터 권한과 사람 승인 지점도 확인합니다.
보안 · CWE-bench v1
취약점 수정 능력을 평가합니다. 점수가 허용 작업의 범위를 뜻하지는 않습니다.
DeepSWE v1.1에서는 Argon이 Astra보다 3.8%p 높습니다. FrontierSWE v2에서는 Astra가 Argon보다 10.5%p 높습니다. 같은 코드 변경 영역에서도 평가에 따라 앞서는 모델이 바뀝니다. 하네스는 모델에게 도구를 제공하고 실행·채점을 관리하는 환경입니다. 비교할 때는 과제뿐 아니라 이 환경과 성공 조건도 확인해야 합니다.
Google이 공개한 원본 차트
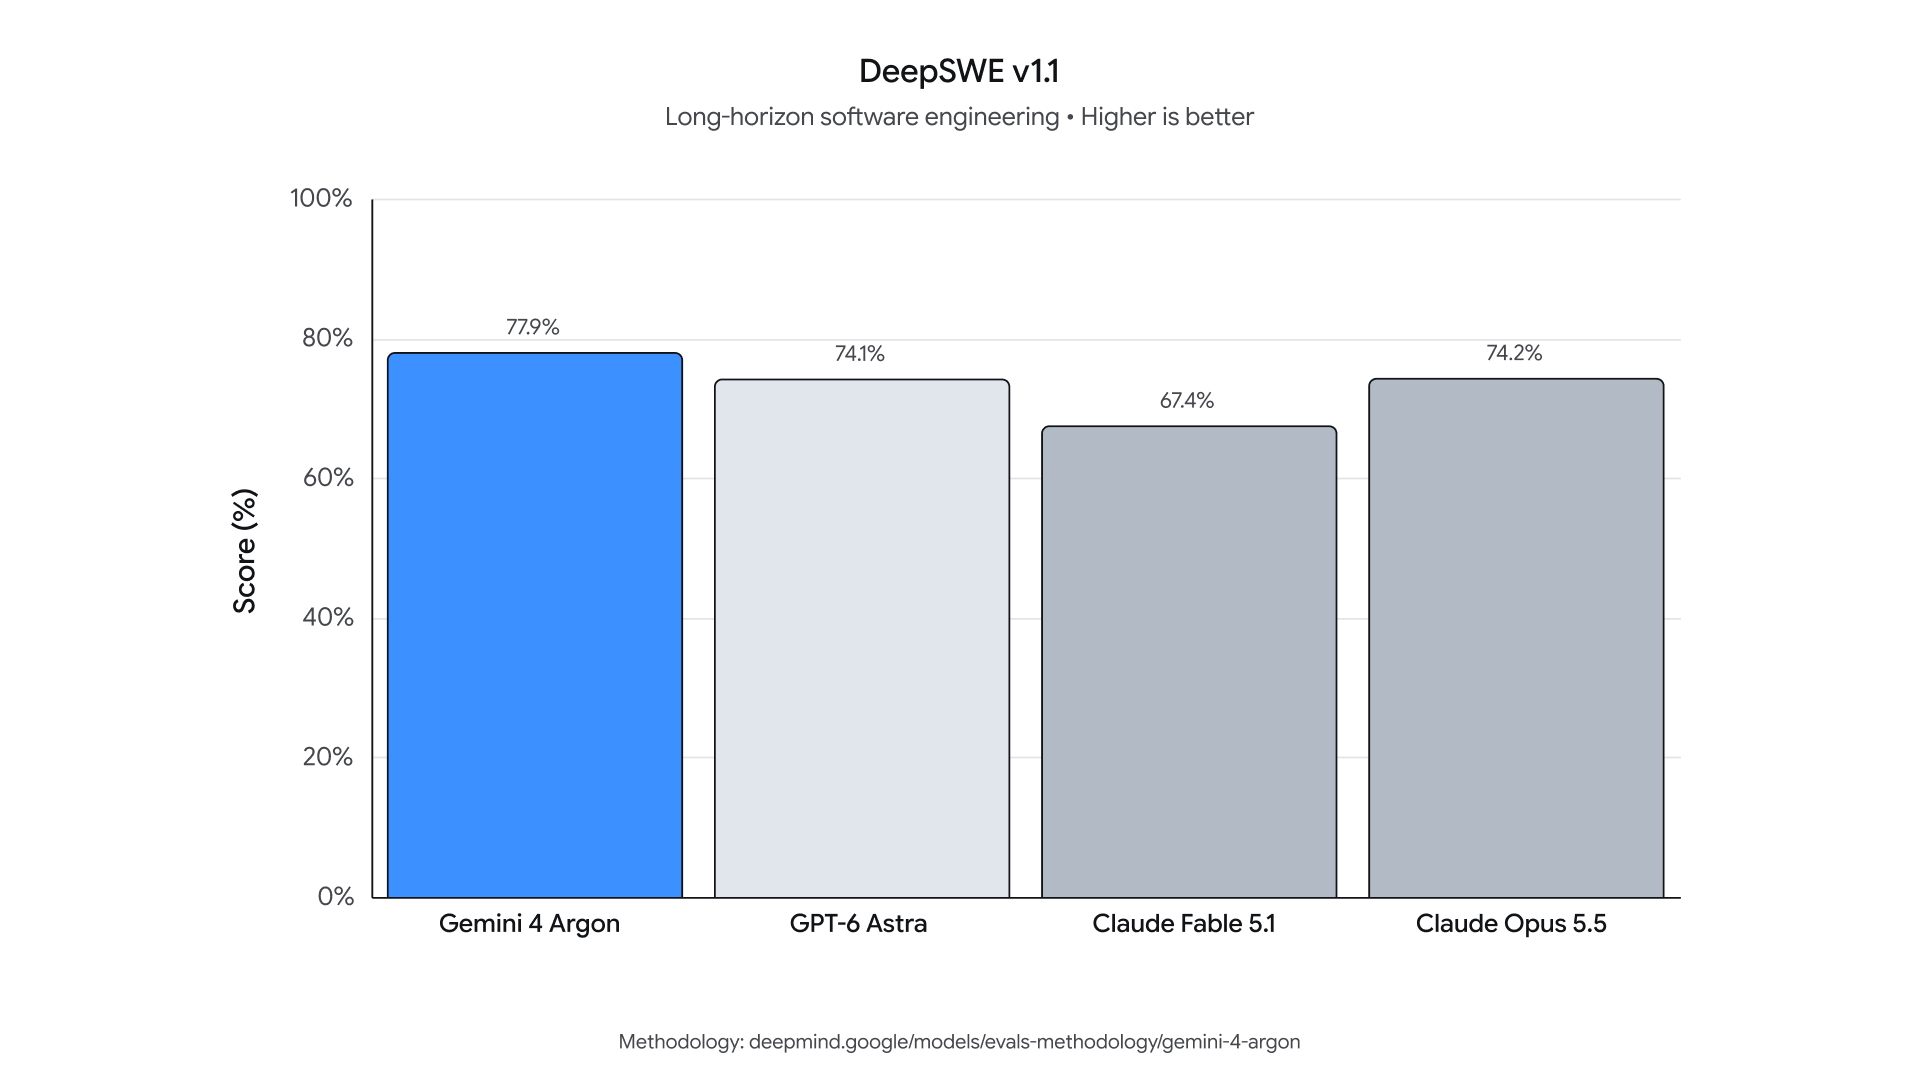
Google의 최초 발표 ↗에 실린 원본입니다. 위의 세 모델 외에 Claude Opus 5.5도 포함하며, 74.2%를 기록했습니다. 모바일에서는 이미지 안의 작은 글자보다 앞의 가로 막대와 수치를 참고할 수 있습니다.
Astra는 컴퓨터 사용과 Codex 작업을 앞세웁니다
OpenAI의 GPT-6 Astra 발표 ↗는 컴퓨터 사용과 장기 Codex 작업을 주요 사용처로 제시합니다. OpenAI는 Astra를 자사의 첫 Critical 등급 사이버보안 모델로 분류했습니다. 고위험 보안 작업에는 모델의 거부 규칙과 함께 모니터링·도구 사용 제한을 둡니다.
Astra를 검토한다면 자동으로 수행할 행동부터 정해야 합니다. 예를 들어 패치 후보를 만들고 테스트를 실행하는 단계와, 프로덕션에 배포하는 단계는 서로 다른 권한을 요구합니다. 제품의 컴퓨터 사용 기능과 실제 조직의 승인 절차가 맞는지 확인합니다. Astra의 컴퓨터 사용과 안전 경계를 다룬 글에서 더 자세히 살펴볼 수 있습니다.
비용도 단계별로 나눠 봅니다. GPT-6 Sol·Luna 발표 ↗는 Astra보다 빠르고 저렴한 선택지를 설명합니다. 모든 단계에 같은 모델을 쓰기 전에 계획·구현·검토 중 어디에서 높은 성능이 필요한지 측정합니다.
Fable 5.1은 여러 앱을 오가는 장기 작업을 지원합니다
Anthropic의 Fable 5.1 안내 ↗는 몇 시간 동안 여러 애플리케이션을 오가는 작업을 제시합니다. 코드베이스 전체의 기능 개발, 브라우저 조작, Claude Platform의 관리형 에이전트가 사용 사례입니다. 기존 Claude 도구와 연결하려는 팀이 검토할 경로입니다.
보안·생물학 분야의 요청이 안전장치에 걸리면 성능이 낮은 모델로 자동 전환될 수 있습니다. 허용된 보안 업무가 영향을 받는 팀은 Cyber Verification Program을 신청할 수 있습니다. 따라서 Fable 5.1의 점수와 함께 실제 요청에서 어느 모델이 작업을 수행하는지도 확인해야 합니다.
Argon 역시 일반 제공과 Fairwind Program의 보안 방어자 접근을 구분합니다. Google의 일반 제공 발표 ↗가 접근 범위를 넓혔어도 제품별 사용 정책은 적용됩니다. 세 모델 모두 보안 업무에서는 허용 역할·데이터 보관·감사 기록·사람 검토 경로를 별도로 확인해야 합니다.
업무에 따라 먼저 시험할 경로를 고릅니다
다음 도식은 앞에서 설명한 제품 특성을 업무별로 연결한 선택 가이드입니다. 모델 간 종합 성능 순위를 뜻하지 않습니다.
긴 문서·영상·저장소 분석
→ Gemini 4 Argon
멀티모달 입력과 최대 100만 토큰의 입력·출력 범위를 활용합니다. 긴 입력의 비용·응답 시간·근거 회수 정확도를 측정합니다.
컴퓨터 사용·Codex 장기 작업
→ GPT-6 Astra
Codex와 컴퓨터 사용 경로를 검토합니다. 허용할 도구와 고위험 행동의 승인 지점을 정합니다.
여러 앱을 오가는 Claude 작업
→ Claude Fable 5.1
Claude 생태계의 장기 실행 경로를 검토합니다. 안전장치에 따른 모델 전환과 데이터 보관 조건을 확인합니다.
보안 업무 자동화
→ 세 모델을 격리 환경에서 평가
점수 외에 허용 작업과 모니터링 정책을 비교합니다. 패치의 테스트·리뷰·되돌리기 절차를 확인합니다.
같은 모델도 API, IDE, 관리형 에이전트에서 사용할 수 있는 도구가 다릅니다. 실제 업무 샘플을 읽기 전용 환경에서 먼저 실행합니다. 결과 품질과 함께 도구 호출, 실패, 사람 개입, 비용을 기록하면 제품 경로까지 포함해 비교할 수 있습니다.
Argon의 첫 시험은 작은 작업으로 시작합니다
개발자 제공 안내 ↗에서 계정에 맞는 경로를 확인한 뒤, 문서 묶음이나 저장소 일부로 시작합니다. 처음부터 컨텍스트 한도를 채울 필요는 없습니다.
- 근거를 요청합니다. 답변이 참조한 파일·문단을 함께 적게 하고, 원문과 대조합니다.
- 읽기와 수정을 구분합니다. 자료를 읽고 계획을 세우는 단계부터 시작합니다. 코드 수정이나 외부 전송에는 필요한 권한만 부여합니다.
- 비용과 시간을 측정합니다. 같은 입력으로 사용한 토큰과 응답 시간을 기록합니다. 100만 토큰은 용량 한도입니다.
- 검토 지점을 정합니다. 패치 제안은 테스트·리뷰를 거치게 합니다. 배포·공개·외부 스캔에는 명시적 승인을 둡니다.
모델 카드는 시험할 후보를 좁히는 자료입니다. 최종 선택은 자신의 문서와 코드, 도구, 승인 절차를 넣은 작업에서 판단합니다.
2026-10-14 수정: 비교표를 여섯 막대 차트와 업무별 선택 도식으로 바꿨습니다. 공식 DeepSWE 이미지를 추가하고 GraphWalks 명칭을 바로잡았습니다.
참고 자료
- Google DeepMind: Gemini 4 Argon 모델 카드 ↗ — 입력·출력, 100만 토큰 컨텍스트, 평가, 한계, 안전 정책
- Google: Gemini 4 Argon 개발자 제공 안내 ↗ — API·AI Studio·Antigravity·Android Studio 접근 경로
- Google: Gemini 4 Argon 최초 발표 ↗ — Fairwind Program과 초기 제공 범위
- Google: Gemini 4 Argon 일반 제공 ↗ — 확대된 제공 범위·활용 사례
- OpenAI: GPT-6 Astra ↗ — 컴퓨터 사용·Codex·안전 경계
- OpenAI: GPT-6 Sol and Luna ↗ — GPT-6 계열의 비용·코딩·컴퓨터 사용 비교
- Anthropic: Claude Fable 5.1 ↗ — 장기 에이전트 작업, 제공 범위, 안전장치